GitHub Copilot ya puede repartir una misma tarea entre varios modelos y cobrar solo lo que estos consumen. El ahorro es grande y está medido. La calidad acompaña menos de lo que dice el titular, y para una empresa esa diferencia importa.
En esta nueva edición de la serie Hablemos de… volvemos a las herramientas con las que se construye software, aunque esta vez el protagonista es una forma de usar los modelos más que un modelo concreto: Project HydraFusion, el research preview que GitHub presentó el 4 de septiembre de 2026 y que desde el 30 de septiembre se puede usar también en VS Code y en la app de GitHub Copilot. Con él, el desarrollador deja de elegir modelo y el sistema decide cómo resolver cada tarea, repartiendo el trabajo entre varios modelos cuando le compensa.
Para entenderlo hay que distinguir antes tres ideas que se suelen mezclar: el router de modelos, la cascada y la fusión de modelos. Con eso claro, la pregunta para una empresa es práctica: cuánto ahorra, qué se pierde por el camino y qué control conserva.
HydraFusion recorta el coste entre un 36% y un 67% frente a usar solo Claude Opus 5 en los tres benchmarks que publica GitHub, pero solo mejora la calidad en uno. El ahorro viene de repartir mejor el trabajo entre los modelos que ya existen.
Demasiados modelos para elegir a mano
OpenRouter, el mayor agregador de modelos, ofrece ya más de 500. A eso se suman los que cada nube publica por su cuenta, los de pesos abiertos que se ejecutan en local y las versiones nuevas que salen cada semana. Las diferencias de precio son enormes: en la tabla de GitHub Copilot, un millón de tokens de entrada cuesta desde 0,10 dólares en la gama económica hasta 10 en la frontera, cien veces más.
Con ese abanico, la pregunta de qué modelo usar para cada tarea se ha convertido en un problema de ingeniería que nadie quiere resolver a mano cada mañana. Elegir de más multiplica la factura y elegir de menos produce trabajo que hay que rehacer.
Router, cascada y fusión: tres ideas distintas
- Router de modelos. Una capa que, ante cada petición, decide a qué modelo enviarla. Puede basarse en reglas simples, en un clasificador que puntúa la petición o en datos de uso real. Elige un modelo y ahí termina su trabajo. Es lo que hacen el modo automático de Copilot, OpenRouter o el model router de Azure AI Foundry.
- Cascada. Empieza un modelo barato y una puerta de calidad decide si su respuesta vale o si hay que escalar a uno más potente. Como la mayoría de las peticiones reales se resuelven con el barato, el caro solo se paga cuando hace falta.
- Fusión de modelos. Varios modelos colaboran en la misma tarea: uno redacta, otro de una familia distinta lo revisa y el primero corrige. Cuesta más que una sola llamada y funciona como un pequeño equipo de trabajo, en el que cada modelo revisa lo que hace otro.
HydraFusion combina las tres y elige, petición a petición, cuál conviene.
Qué es HydraFusion y de dónde sale
El nombre une dos piezas. Hydra viene de HyDRA (Hybrid Dynamic Routing Architecture), el sistema de enrutado que Microsoft y GitHub publicaron en arXiv en mayo de 2026 y que ya funciona para todos los usuarios del modo automático de Copilot Chat en VS Code. Fusion describe lo nuevo: coordinar, dentro de un mismo turno, modelos de varios proveedores para redactar, criticar, revisar o escalar. Mario Rodriguez, chief product officer de GitHub, lo resumió así en VentureBeat: el modo automático selecciona un modelo y HydraFusion orquesta un flujo de trabajo. GitHub lo plantea como un problema de optimización: elegir el patrón
más eficiente que alcance el listón de calidad.
Cómo decide en cada petición
El motor puntúa cada petición en cuatro señales independientes: razonamiento, generación de código, depuración y uso de herramientas. Lo hace con un codificador ModernBERT que tarda 86 milisegundos de mediana en CPU. Después, un algoritmo de shortfall matching busca el modelo más barato cuyas capacidades cubren lo que pide la tarea y, con eso, elige uno de tres patrones:
- Single: un modelo resuelve la tarea directamente.
- Cascade: un modelo eficiente redacta, una puerta de calidad revisa y, si no pasa, se escala a un modelo más potente.
- Critique: un modelo redacta, un crítico de otra familia y de solo lectura revisa el trabajo en un contexto aislado y sin herramientas, y el redactor hace una única revisión.
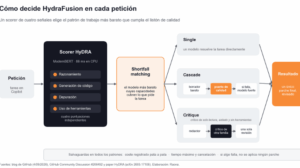
Cómo decide HydraFusion en cada petición. Fuentes: GitHub y paper HyDRA (arXiv 2605.17106). Elaboración: Raona.
GitHub ha añadido salvaguardas de ingeniería que, para una empresa, pesan tanto como el ahorro. Registra el coste de cada pata del flujo, pone tiempo máximo y cancelación a cada una y, si algo se cancela o no valida, no aplica ningún parche. Además, como el sistema está desacoplado del catálogo, añadir o quitar
modelos es un cambio de configuración que no obliga a reentrenarlo.
Lo que dicen los números
GitHub evaluó HydraFusion en tres benchmarks de código agéntico tomando como referencia Claude Opus 5 y GPT-5.6 Sol, con el mismo nivel de razonamiento y contando el coste de todas las patas: borrador, crítica, revisión, escalado y reintentos. La tabla publicada solo detalla la comparación con Opus 5.
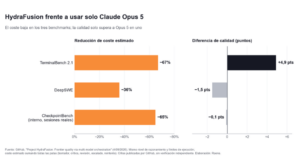
HydraFusion frente a usar solo Claude Opus 5. Cifras publicadas por GitHub, sin verificación independiente. Elaboración: Raona.
En TerminalBench 2.1 cuesta un 67% menos y gana 4,9 puntos de calidad. En DeepSWE ahorra un 36% y pierde 1,5 puntos, y en CheckpointBench, un benchmark interno y multiturno construido con sesiones reales de Copilot, ahorra un 65% y pierde 0,1. VentureBeat lo tituló con precisión: recorta el coste en todos los benchmarks y solo iguala la calidad en uno. El ahorro sale del reparto, porque se paga el modelo barato en la mayoría de los casos y el caro solo en los que no superan la puerta de calidad.
El paper de HyDRA da una pista de hacia dónde puede ir. En SWE-Bench Verified, con cinco modelos, el router mostró tres modos ajustables: superar al modelo fuerte (75,4% frente a 74,2%) ahorrando un 12,9%, igualarlo ahorrando un 54,1%, o ahorrar un 72,5% a cambio de 3,2 puntos de calidad. Es el tipo de control que querría un CIO, que podría decidir cuánto ahorro y cuánta calidad compra.
HydraFusion no tiene coste adicional. Se factura como la suma de los modelos que ejecuta, cada uno a su tarifa estándar.
Cómo activarlo
En Copilot CLI está disponible para todos los planes, y en VS Code y la app, para Copilot Pro, Pro+, Business y Enterprise. En VS Code (versión 1.140 o posterior) basta con elegir HydraFusion en el selector de modelos de Copilot Chat. En la app de GitHub Copilot hay que activarlo en Ajustes, y en Copilot CLI se activa con los comandos /update, /experimental on y /model. En Business y Enterprise, un administrador tiene que permitir antes las funciones en preview.
GitHub recomienda empezar con tareas sustanciales y bien delimitadas que quepan en un único prompt, del tipo que se lanzaría a un agente en modo automático. Las sesiones largas de varios turnos son su siguiente objetivo de mejora.
La letra pequeña
- No se pueden elegir ni excluir modelos, y GitHub no publica una lista fija porque el elenco cambia con cada evaluación. Para una empresa con requisitos de cumplimiento sobre qué proveedor procesa sus datos, puede ser un bloqueo. GitHub reconoce que algunos equipos necesitan más control y dice que lo está estudiando.
- Se ve en qué fase está el flujo, pero no los borradores ni las críticas intermedias. GitHub los retiene porque pueden revisarse o descartarse y no quiere que un trabajo a medias parezca definitivo.
- Ejecutar varias patas por turno añade tiempo, y GitHub todavía no ha publicado cifras de latencia.
- Es un research preview. Según la propia GitHub, los resultados, los modelos, los flujos, la disponibilidad y el comportamiento pueden cambiar. No conviene apoyar en él un proceso crítico sin un plan alternativo.
- GitHub reconoce que entre el 11 y el 25 de agosto dos fallos de su entorno de evaluación produjeron ejecuciones no válidas, que excluyó y corrigió. Se agradece la transparencia, pero los números aún no tienen verificación independiente.
Qué implica para tu empresa
- Con el coste registrado pata a pata, el gasto en IA se puede presupuestar por tipo de tarea en lugar de vigilar una cifra agregada de tokens. Es lo que necesita un comité de IA para aprobar despliegues a escala.
- Elegir modelo consume tiempo de los desarrolladores todos los días y se decide a menudo por intuición. Un router con métricas devuelve ese tiempo al trabajo real.
- El ahorro depende del tipo de tareas. Si son casi siempre difíciles, la cascada apenas ayuda. Si son casi siempre fáciles y ya se usaba un modelo barato, el margen de ahorro es menor. Hay que medirlo con las tareas propias.
- Nvidia con NeMo Switchyard y OpenRouter con su enrutado como servicio apuntan en la misma dirección que GitHub. Todo indica que las empresas dejarán de comprar un modelo y pasarán a operar un conjunto de modelos con reglas de reparto, e HydraFusion es el primer caso masivo que pasa de enrutar a orquestar.
La comodidad de no elegir tiene un precio, que es depender de las decisiones de catálogo de GitHub y Microsoft. Para muchos equipos compensa; para los que tienen requisitos estrictos de proveedor, todavía no.
Cierre
En Raona trabajamos con GitHub y su ecosistema todos los días, como usuarios intensivos y como responsables de su gestión y administración en las organizaciones de nuestros clientes: licencias, políticas de Copilot, permisos y gobierno de funciones en preview como HydraFusion, que en Business y Enterprise solo llega a los desarrolladores cuando el administrador la habilita. Esa experiencia nos permite acompañar la adopción de GitHub Copilot de principio a fin, desde la configuración hasta la medición del impacto.
Si quieres saber qué aportaría la orquestación multimodelo a tu equipo, podemos habilitarla de forma controlada en tu organización, montar una prueba con tus propias tareas y medir antes y después el coste por tarea, la calidad y el encaje con tus políticas de cumplimiento. Con esos datos te damos una recomendación clara. ¡Hablemos!