Retrieve-for-Train, un trabajo de Google Research presentado en ICML 2026, propone aprender la estrategia de búsqueda antes y ejecutarla después con un modelo mucho más pequeño.
En esta nueva edición de la serie Hablemos de… nos toca hablar de búsqueda. En los dos últimos años hemos pedido a los modelos de IA cada vez más trabajo: que busquen, comparen, planifiquen, usen herramientas y revisen su propia respuesta. La calidad ha subido, y buena parte de ese esfuerzo se hace justo cuando el usuario está esperando.
Cada paso de razonamiento consume tokens, añade latencia y encarece el cómputo. En una conversación suelta se tolera. En un buscador corporativo, en un catálogo con millones de referencias o en un servicio que atiende miles de peticiones por minuto, esa misma estrategia se convierte en un problema de arquitectura, de experiencia de usuario y de factura.
Google Research ha publicado un trabajo que ataca este punto en búsquedas complejas. Se llama Retrieve-for-Train (R4T) y plantea una pregunta que interesa a cualquier responsable de tecnología: ¿qué parte del razonamiento hay que ejecutar en cada consulta y qué parte se puede aprender antes y reutilizar?
Si un comportamiento de búsqueda se repite millones de veces, suele salir más barato aprenderlo fuera del camino crítico que reconstruirlo en cada petición.
Cuando la respuesta útil es un conjunto
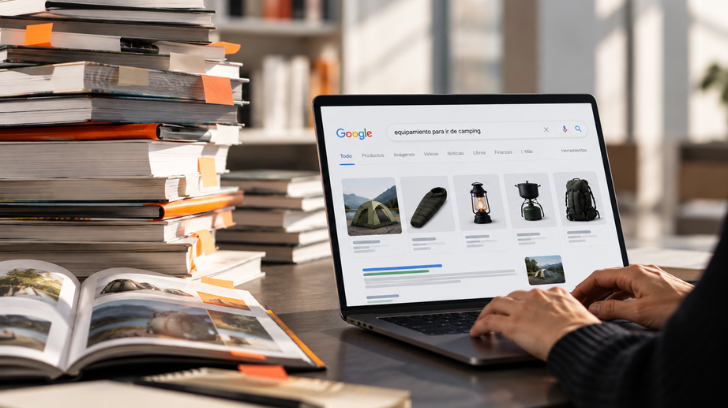
Muchos buscadores se diseñaron para encontrar el resultado más relevante para una consulta. Eso funciona hasta que la intención del usuario es amplia. Quien busca «equipamiento para ir de camping» no quiere diez tiendas de campaña casi iguales: espera una tienda, un saco, una linterna, un hornillo y quizá una mochila. La calidad depende de propiedades del conjunto, como la cobertura, la diversidad y la complementariedad, que no se pueden medir mirando cada resultado por separado.
Google llama a este problema recuperación por conjuntos (set-valued retrieval), y en la empresa aparece con frecuencia: un buscador de producto que debe cubrir varias categorías, un sistema documental que tiene que traer evidencias desde ángulos distintos o un RAG que mejora cuando recupera fragmentos complementarios en vez de diez versiones del mismo párrafo.
El atajo habitual y su coste
La solución más extendida es pedir a un modelo de lenguaje que descomponga la consulta en varias subconsultas, lo que se conoce como query fan-out. Es flexible y lo usan buscadores con IA, arquitecturas RAG y agentes. A escala, tiene dos límites.
El primero es la redundancia. Un modelo generalista tiende a producir reformulaciones que suenan distintas y apuntan al mismo sitio: «moda bohemia para festival», «ropa bohemia para festival»… El paper lo llama colapso parafrástico. Se genera más texto sin explorar mejor.
El segundo es estructural. Un LLM escribe token a token, así que analizar la intención y generar diez direcciones de búsqueda ocurre antes de recuperar nada. Cuanto más sofisticado es el razonamiento, más espera el usuario, y en búsqueda la gente está acostumbrada a resultados casi instantáneos.
Qué propone Retrieve-for-Train
R4T separa dos momentos que solemos mezclar: cuando el sistema aprende cómo debe buscar y cuando ejecuta esa búsqueda para un usuario real.
En la fase de entrenamiento, los autores usan aprendizaje por refuerzo para enseñar a modelos de lenguaje de 4.000 millones de parámetros (Gemma3-4B y Qwen3-4B) a generar buenos fan-outs. La recompensa evalúa el conjunto completo y equilibra tres cosas: que las subconsultas apunten a contenido que existe en la base de datos, que sigan fieles a la intención original y que exploren zonas diferentes. Premiar solo la primera lleva a atajos inútiles para una persona; premiar solo la segunda devuelve las paráfrasis de siempre. La diversidad hace de contrapeso.
Después, ese modelo entrenado genera de forma offline pares de consulta y conjunto objetivo, y con esos datos sintéticos se entrena un recuperador basado en difusión de solo 53,9 millones de parámetros. Aquí «difusión» no tiene nada que ver con generar imágenes: el modelo trabaja sobre embeddings y produce varias direcciones de búsqueda a la vez, sin escribir texto token a token.
Los números del experimento
Los autores lo prueban en dos dominios: moda, con el dataset de outfits Polyvore, y música, con un conjunto industrial de playlists creadas por expertos. La reducción de latencia del fan-out se sitúa entre 12 y 20 veces frente a las alternativas autorregresivas. Con lotes de 8 consultas, el LLM tarda 1,46 segundos y el modelo de difusión 0,07; con lotes de 1.024, casi 50 segundos frente a 4,21.
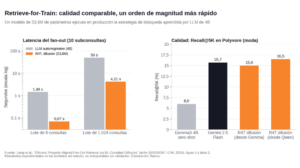
Latencia y calidad de Retrieve-for-Train frente a los enfoques autorregresivos. Fuente: Jiang et al., arXiv 2603.06397. Elaboración propia.
La calidad aguanta. En la tarea de recuperación composicional sobre Polyvore, el recuperador de 53,9M alcanza un Recall@5K de entre 15,0 y 16,5, en la línea de Gemini 2.5 Flash (15,7) y muy por encima del modelo de 4B sin entrenar (6,0).
Son resultados de laboratorio en dominios y datasets concretos. No significan que cualquier buscador vaya a ser veinte veces más rápido, pero sí demuestran que un comportamiento de búsqueda complejo se puede aprender con un modelo potente y ejecutar luego con un componente ligero que conserva lo aprendido.
Razonamiento compilado
Una analogía de ingeniería ayuda a entenderlo, aunque no es el término de los autores: razonamiento compilado. Un sistema puramente dinámico decide en cada consulta cómo interpretarla y hacia dónde buscar. Se adapta a todo y paga ese coste cada vez. R4T invierte el razonamiento en una fase previa y deja en producción un mecanismo que ejecuta lo aprendido de forma directa. El LLM sigue aportando valor, pero lo hace construyendo el sistema, sin ocupar el camino crítico de cada búsqueda.
Esto encaja con una pregunta que empieza a aparecer en muchas arquitecturas. Dar más cómputo al modelo en el momento de responder mejora los resultados en problemas difíciles, pero cuando una tarea se repite con mucha frecuencia conviene preguntarse si queremos seguir pagando ese razonamiento en cada ejecución.
Qué significa para RAG, agentes y búsqueda empresarial
En una edición anterior de Hablemos de… explicábamos que un RAG maduro va mucho más allá de embeddings y una base vectorial: búsqueda híbrida, reranking, filtros de seguridad, evaluación y agentes que deciden cuándo consultar. R4T añade una capa a esa conversación: además de elegir los componentes del pipeline, hay que decidir cuáles deben ser dinámicos y cuáles pueden especializarse a partir del comportamiento observado.
Pensemos en un buscador interno que usan miles de empleados. Si las consultas cambian sin parar y abarcan dominios muy distintos, un LLM que interprete cada petición sigue siendo la herramienta adecuada. Si en cambio hay familias estables de consultas (producto, soporte técnico, procedimientos, catálogo), tiene sentido entrenar componentes especializados que resuelvan parte del trabajo de forma más rápida y predecible. Con los agentes pasa algo parecido: cuando una misma decisión se repite cientos de miles de veces con una estructura reconocible, se puede medir, aprender y convertir en una pieza especializada.
Más allá de la velocidad y el coste, este enfoque tiene tres efectos que importan en una empresa:
- Previsibilidad: un componente acotado es más fácil de medir que un agente con razonamiento variable, y eso facilita fijar niveles de servicio y detectar regresiones.
- Observabilidad: obliga a convertir ideas vagas como «una buena selección» en métricas concretas de alineamiento, diversidad y anclaje al contenido real.
- Gobierno: el recuperador entrenado, las recompensas y el dataset sintético pasan a ser activos que hay que versionar, validar y mantener. Si el catálogo cambia mucho, el modelo puede degradarse. La complejidad se traslada al entrenamiento y a la operación.
Dónde tiene sentido explorarlo
El patrón encaja cuando coinciden un dominio estable, un volumen de consultas que haga relevante la latencia o el coste, objetivos de recuperación medibles y datos suficientes. Catálogos de producto, recomendación y buscadores verticales son candidatos naturales. Cuanto más abierta y cambiante es la tarea, más valor conserva el razonamiento dinámico. Un asistente que responde preguntas muy heterogéneas sobre muchas fuentes corporativas seguirá necesitando un modelo general durante buena parte del flujo.
R4T amplía el repertorio de arquitectura sin sustituir a los LLM. La lección práctica es separar el momento de aprender del momento de servir: cada vez que añadimos un LLM a una etapa del pipeline, merece la pena preguntarse si necesitamos su capacidad general en ese instante o si estamos pagando una y otra vez por un comportamiento que el sistema podría haber aprendido antes. En muchos proyectos, la próxima mejora vendrá de decidir qué parte de la inteligencia se queda dinámica y qué parte se convierte en infraestructura, más que de un modelo más grande.
En Raona, hablemos
Si tu organización está construyendo buscadores inteligentes, soluciones RAG o agentes y empieza a notar límites de latencia, coste o calidad de recuperación, conviene revisar la arquitectura completa antes de añadir más razonamiento al flujo. En Raona diseñamos y llevamos a producción soluciones de IA que combinan modelos generativos, recuperación avanzada y componentes especializados según lo que pide cada caso. Cuéntanos tu escenario y lo analizamos juntos. ¡Hablemos!
Fuentes
- Google Research, «Bypassing inference bottlenecks: Accelerating complex AI search with Retrieve-for-Train», 15 de septiembre de 2026. https://research.google/blog/bypassing-inference-bottlenecks-accelerating-complex-ai-search-with-retrieve-for-train/
- Jiang, P. et al., «Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion», arXiv:2603.06397, ICML 2026. https://arxiv.org/abs/2603.06397
- Google Research, «Google at ICML 2026». https://research.google/conferences-and-events/google-at-icml-2026/
- Raona, «Hablemos de RAG: diseñando una buena arquitectura». https://raona.com/arquitectura-rag-ia-empresas/
Las cifras corresponden a los experimentos publicados por los autores en los dominios y configuraciones del estudio y no deben extrapolarse a otros sistemas sin una validación específica.