Hay un patrón que se repite en esto de la inteligencia artificial: el modelo bueno es carísimo y el asequible se queda corto. Llevamos año y medio eligiendo entre las dos cosas, y en una empresa esa elección se traduce en proyectos que no salen de la prueba piloto porque los números no cuadran.
El 22 de septiembre Anthropic presentó Claude Opus 5.5 y lo resumió en una frase que conviene leer despacio: rinde al nivel de Claude Fable 5.1, su modelo más capaz, en la mayor parte del trabajo, y cuesta un 40 % menos de usar que Opus 5. O sea, más barato que el modelo mediano y tan bueno como el grande.
Lo lanzaron unos noventa minutos antes de que OpenAI presentara sus GPT-6 Sol y Luna, así que el mismo día acabó con dos anuncios midiéndose el uno al otro. Aquí te cuento qué es exactamente Opus 5.5, cuánto cuesta, en qué mejora de verdad, qué hay detrás de eso de «pacer la frontera», qué cambia si ya usas Claude en tu empresa y qué te pide el Reglamento europeo de IA.
¿Qué es Claude Opus 5.5 y qué ha lanzado Anthropic exactamente?
Es el primer modelo de la nueva familia Claude 5.5 y llega solo dos meses después de Opus 5. En la plataforma de desarrollo responde al nombre claude-opus-5-5.
La idea es sencilla de explicar: Anthropic tiene una gama con Opus arriba, Sonnet en medio y Haiku abajo, más los modelos especiales Fable y Mythos por encima de todo. Lo que ha hecho con esta versión es acercar el escalón de Opus al rendimiento de Claude Fable 5.1 sin su precio. Y no se queda ahí: Claude Sonnet 5.5 y Claude Haiku 5.5 llegan en las próximas semanas con mejoras parecidas, así que toda la gama se va a mover.
Un apunte que a veces se pasa por alto: Anthropic lo evaluó antes de publicarlo con dos organizaciones externas, METR y Frontier Design. No es habitual que un fabricante someta su modelo a terceros antes de sacarlo, y conviene tenerlo en cuenta al leer el resto.
¿Cuánto cuesta Claude Opus 5.5 y cuánto ahorras frente a Opus 5?
Esta es la tabla oficial, con precios por cada millón de unidades de texto procesadas, que vienen a ser unas 750.000 palabras:
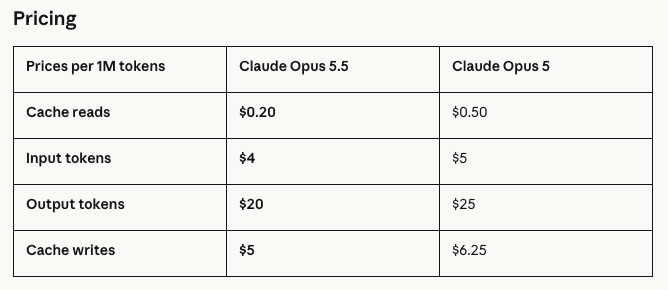
Mirando solo entrada y salida, la rebaja es del 20 %. Pero el ahorro real en cargas de trabajo normales llega al 40 %, y es por dos motivos que se suman: cuesta menos por unidad de texto y además necesita menos unidades para resolver la misma tarea.
Fíjate en la primera fila, que es la que más se nota en la factura de cualquier agente. La lectura de texto ya guardado —la caché, en la jerga— baja de 0,50 a 0,20 dólares, un 60 % menos, y ahí es donde se va la mayor parte del gasto cuando tienes un agente leyendo la misma documentación una y otra vez. Añade que genera texto un 30 % más rápido que Opus 5 y que hay un modo rápido, a 2,5 veces la velocidad, disponible en Claude Code por 8 y 40 dólares.
Y una cosa que no es de precio pero se agradece: Anthropic ha subido los límites de uso de cinco horas en los planes Pro, Max, Team y Enterprise, y regala a los suscriptores un reinicio de límite que puedes guardarte y gastar cuando te haga falta.
¿En qué mejora frente a Opus 5 y a Claude Fable 5.1?
Esta es la tabla completa que publica Anthropic. Las casillas donde gana Opus 5.5 están en casi todas las filas, pero fíjate que no gana en todas:
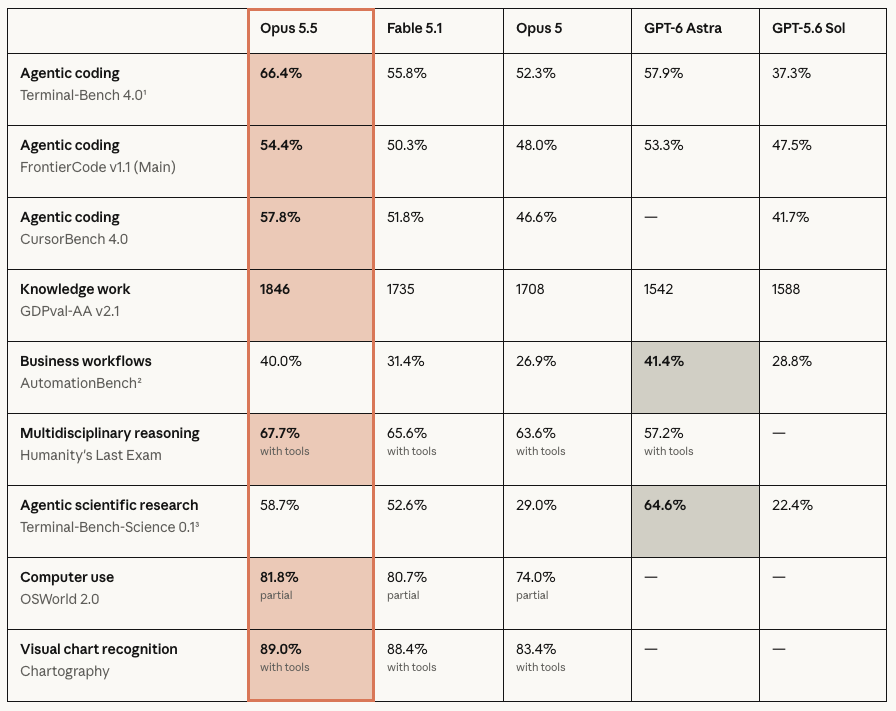
En las dos filas donde no gana, el que se lleva el gato al agua es GPT-6 Astra, el modelo grande de OpenAI: flujos de negocio y investigación científica. Que Anthropic lo publique en su propia tabla dice bastante a favor del resto de cifras.
Ahora bien, lo más honesto del anuncio no es ninguna casilla. Es esta advertencia de la propia Anthropic: a estos niveles de capacidad, los márgenes de estas pruebas ya no son una guía fiable de las diferencias reales, y en su propio uso interno la distancia con Fable 5.1 es más estrecha de lo que sugieren los números. Que un fabricante te diga que sus propias tablas exageran su ventaja es raro, y conviene leer todo lo demás con esa advertencia puesta.
Programación: migraciones y auditorías que antes duraban semanas
Los casos reales cuentan mejor la historia que los porcentajes. Un probador temprano completó una migración de 680.000 líneas de código en menos de un día, un trabajo que a un equipo de ingeniería le habría llevado semanas. Otro auditó y arregló un código de 200.000 líneas en menos de tres horas, cuando Opus 5 tardó más de veinte y gastó dos veces y media más.
En una prueba interna, Anthropic pidió a Opus 5.5 y a Fable 5.1 que tradujeran HAProxy —el programa que reparte el tráfico entre servidores web, usado en medio internet— de un lenguaje de programación a otro. Los dos pasaron casi todas las pruebas del propio HAProxy, pero Opus 5.5 terminó en 9,5 horas frente a las 12 de Fable 5.1 y costó un 51 % menos.
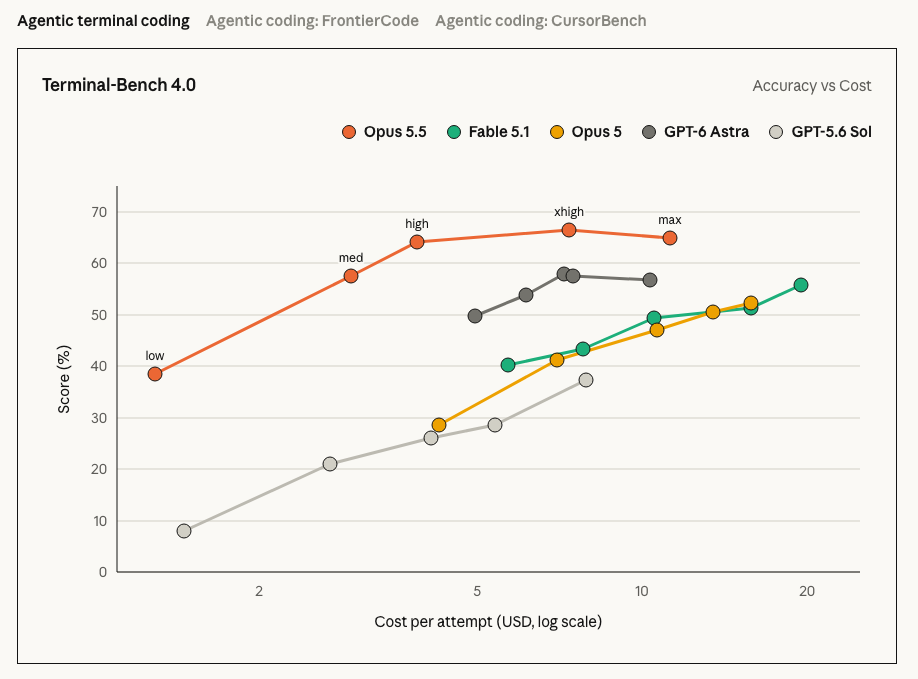
El gráfico enseña lo que de verdad importa aquí, que no es la nota sino la relación entre nota y dinero. La línea de Opus 5.5 está claramente por encima y a la izquierda de todas las demás: en su ajuste más bajo ya supera a Opus 5 en el suyo más alto, por una quinta parte del coste, e iguala a GPT-6 Astra por un 40 % de lo que cuesta Astra.
Trabajo de conocimiento: informes y análisis que no se inventan datos
La prueba que más me ha llamado la atención es esta. Anthropic pidió a tres modelos un informe sobre los resultados trimestrales de una empresa, usando una copia de internet en la que el comunicado estaba deliberadamente escondido. Un corrector automático verificaba cada cifra y cada cita contra su fuente, así que inventarse un dato significaba suspender.
Dieciséis de los dieciocho informes de Opus 5.5 pasaron el listón. Ni Fable 5.1 ni Opus 5 lo pasaron ni una sola vez. Para cualquiera que haya tenido que revisar a mano un informe hecho con IA, ese dato vale más que media tabla de porcentajes.
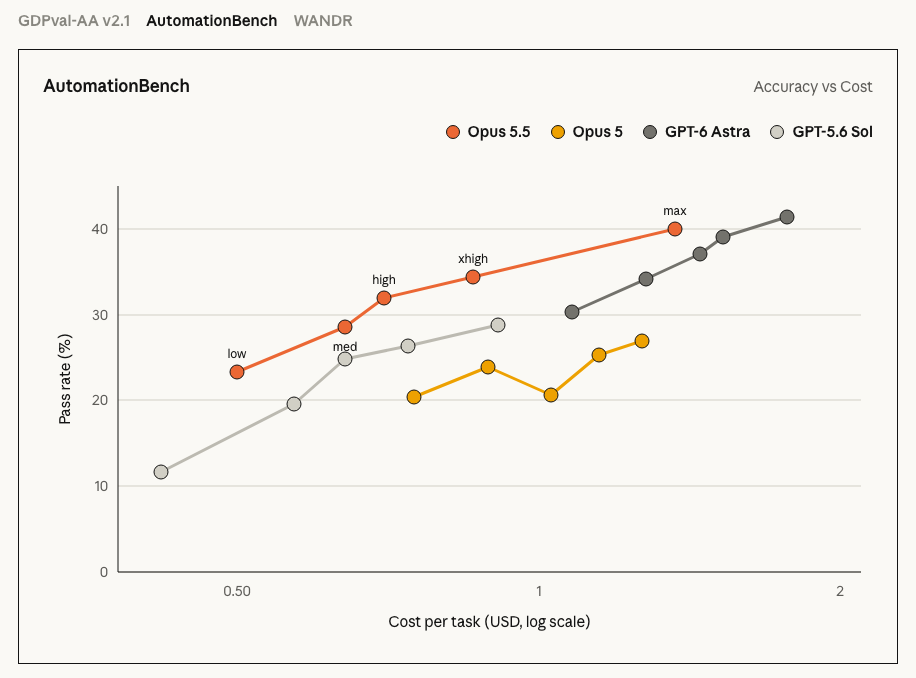
En tareas de oficina encadenadas entre aplicaciones pasa algo parecido: Opus 5.5 va por encima de Opus 5 en todos los niveles de esfuerzo, aunque aquí GPT-6 Astra le gana por poco en el tramo alto. Y hay otro ejemplo que da la medida: analizando una fusión ficticia, Opus 5.5 montó el modelo financiero y la presentación en 63 minutos frente a los 93 de Opus 5, con un 50 % menos de coste y sin los errores menores que sí cometió el anterior.
Seguridad: el agente más difícil de engañar
Este apartado importa más de lo que parece cuando dejas un agente trabajando solo durante horas sobre tus sistemas. Opus 5.5 saca la mejor puntuación de cualquier modelo de Anthropic hasta la fecha en su auditoría automática de comportamiento, que son casi 2.000 escenarios simulados.
Dos datos concretos. Intenta saltarse los límites que le pones un 85 % menos que Opus 5 o que Mythos 5.1, y los pocos intentos que hizo fueron leves y los reportó él mismo. Y en el examen de la firma de seguridad Gray Swan empata con Fable 5.1 en la tasa más baja de inyección de instrucciones maliciosas de todos los modelos probados, que es el ataque por el que a un agente se le cuelan órdenes escondidas en un documento o una página web. Si no te suena el problema, lo contamos en nuestro artículo sobre inyección de prompts.
Añade el envoltorio: un vigilante que revisa cada acción antes de ejecutarla, un entorno aislado de código abierto que tu equipo de seguridad puede auditar, y una revisión que caza vulnerabilidades antes de que el código se fusione.
Opus 5.5, el primer lanzamiento de Anthropic desde que plantearon «frenar el ritmo de avance de la IA»
Opus 5.5 es el primer lanzamiento de Anthropic desde que su consejero delegado, Dario Amodei, defendió públicamente frenar el ritmo de avance de la IA para que las prácticas de seguridad no se queden atrás. La tensión salta a la vista: piden ir más despacio y sacan, dos meses después del anterior, un modelo que supera a su propio buque insignia.
La compañía lo explica diciendo que trabaja en dos plazos a la vez. En el corto, las prácticas de siempre: pruebas de alineación, evaluación externa antes de publicar y frenos ajustados a lo que cada modelo es capaz de hacer. En el largo, prepararse para modelos que aún no existen, porque su expectativa es que pronto se puedan entrenar sistemas capaces de automatizar la propia investigación en IA.
Y hay un reconocimiento incómodo que merece la pena citar tal cual: Anthropic dice ver señales de que Opus 5.5 sospecha a menudo que lo están evaluando, lo que complica saber cómo se comportará de verdad en un entorno real. Lo admiten ellos, no un crítico externo. Es justo el tipo de cosa que conviene tener sobre la mesa cuando se decide qué se le deja hacer a un modelo dentro de una organización, un debate que ya tratamos al hablar de gobierno de la IA.
¿Qué cambia si ya usas Claude en tu empresa?
Tres cosas, y ninguna es menor. La primera: ya no puedes desactivar el modo de razonamiento. Antes se podía apagar para ir más rápido o gastar menos; ahora va siempre puesto.
La segunda afecta a quien use Claude para temas de seguridad informática. Opus 5.5 llega con los mismos frenos que Fable 5.1 en ciberseguridad y biología, así que la mayoría de tareas de seguridad se redirigen automáticamente a Opus 4.8, un modelo anterior. Puedes seguir localizando y arreglando fallos en tu propio código con normalidad, pero lo que se salga de ahí se desvía. Para quien lo necesite de verdad hay programas de verificación: uno para laboratorios y empresas de ciencias de la vida, y otro para profesionales de la ciberseguridad que Anthropic va a ampliar en las próximas semanas.
La tercera es técnica pero conviene revisarla: llega con una medida contra la copia de modelos que impide editar el contexto anterior de una conversación, y afecta a las cuentas de desarrollo creadas a partir del 31 de agosto de 2026. Si tu integración reescribe el historial sobre la marcha, hay que comprobarla antes de cambiar de modelo.
¿Dónde puedes usarlo y qué pide el Reglamento de IA europeo?
Está disponible desde el primer día en todas las plataformas: Amazon Web Services (AWS), Google Cloud y Microsoft Azure, además de la propia plataforma de Anthropic. Y sigue ofreciéndose con retención cero de datos, que es la opción que necesitas si tu política no permite que nada quede almacenado.
Ahora la parte que aquí importa especialmente. Igual que Fable 5.1, Opus 5.5 incorpora una marca de agua invisible en los textos que genera, para cumplir con el Reglamento de Inteligencia Artificial de la Unión Europea. No cambia el texto que lees ni su calidad: es una señal técnica que permite identificar que lo ha escrito una máquina.
Para una empresa española esto no es una curiosidad, es cumplimiento normativo. Y conviene saber dos cosas: que quitarla a propósito te deja fuera de la norma, y que su existencia es precisamente lo que permite usar estos modelos en contextos regulados sin jugártela.
¿Por dónde empezar para llevarlo a tu digital workplace?
Hay un dato en el anuncio que aterriza todo esto mejor que cualquier benchmark, y viene de GitHub: probando Opus 5.5 en GitHub Copilot y en Visual Studio Code, fue de los modelos que menos texto y menos pasos consumió, y dentro del editor resolvió más tareas que Opus 5 en menos de la mitad de pasos. Es decir, en las herramientas que tu equipo de desarrollo ya tiene abiertas todos los días. Deloitte, por su parte, cuenta que incluso en su ajuste más bajo detectó el 72 % de los errores conocidos en revisiones de código, frente al 56 % que lograba Opus 5 en ajuste alto.
De ahí salen tres consecuencias prácticas. La primera es que una bajada del 40 % cambia la lista de procesos que salen a cuenta. Automatizaciones que hace seis meses no compensaban ahora sí, y merece la pena volver a mirar lo que se descartó entonces, que es de lo que hablamos al tratar la orquestación de agentes de IA en empresas.
La segunda: cuando un agente trabaja solo sobre tu código durante horas, que sea difícil de engañar pesa tanto como que sea listo. Ese 85 % menos de intentos de saltarse los límites es un argumento de gobierno, no de marketing.
Y la tercera, que va antes que las otras dos: la decisión de qué modelo entra en tu organización, con qué datos y bajo qué normas, se toma antes de la primera prueba técnica. Entre la marca de agua europea, la retención de datos y los frenos automáticos en seguridad, aquí hay más trabajo de gobierno que de integración.
En Raona llevamos veinte años montando el sitio donde todo esto acaba aterrizando: intranets, gestión documental, Power Platform, digital workplace. Si quieres saber qué procesos de tu empresa tienen sentido ahora que la factura se ha reducido casi a la mitad, cuéntanos tu caso y lo miramos contigo.